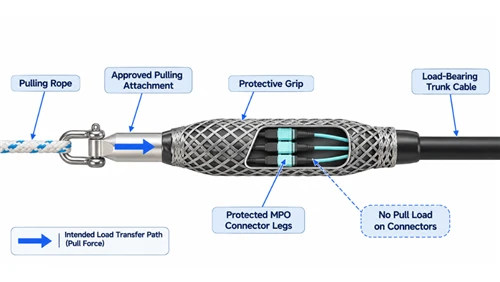
En un clúster de GPU, la red no es una capa de soporte -, ella decide si los costosos aceleradores computan o permanecen inactivos esperando datos. La red de clústeres de IA determina directamente la velocidad de entrenamiento, la utilización de GPU y el tiempo de finalización del trabajo, y se comporta de manera muy diferente a una red de centro de datos-de uso general. Esta guía cubre cómo diseñar una estructura sin pérdidas para cargas de trabajo de GPU: topología, configuración de RoCEv2, óptica y cableado de 400G/800G, y la validación que separa una estructura que pasa una prueba de ancho de banda de una que realmente termina los trabajos de entrenamiento a tiempo.
Diseño de red de clústeres de IA
Un tejido de clúster de IA bien-diseñado separa el tráfico frontend y backend, utiliza una topología de columna vertebral sin-bloqueo o con baja-suscripción-para el backend, ejecuta RoCEv2 con PFC, ECN y DCQCN ajustados para que ECN actúe antes que PFC, distribuye grandes flujos con balanceo de carga consciente-de la congestión en lugar de ECMP predeterminado solo, estandariza hoy en 400G con un camino claro hacia 800G y se valida con telemetría correlacionada con IA-como el tráfico colectivo -, no solo con simples pruebas de rendimiento.
Diseño de red de clústeres de IA de un vistazo
| Decisión | Valor predeterminado recomendado |
|---|---|
| Dominios de tráfico | Separe las telas de frontend y backend |
| Topología de backend | Leaf-spine, sin-bloqueo o baja sobresuscripción |
| Transporte | RoCEv2 con PFC + ECN + DCQCN |
| Equilibrio de carga | Congestión-consciente/dinámica, no solo ECMP predeterminado |
| Velocidad del puerto | 400G ahora, con una migración planificada a 800G |
| Validación | Telemetría más tráfico colectivo (NCCL), no solo iperf |

¿Qué es la red de clústeres de IA?
Las redes de clústeres de IA son el tejido de alto-rendimiento que conecta servidores GPU, almacenamiento, nodos de administración y, a veces, varios dominios de centros de datos para entrenamiento o inferencia. Un solo clúster transporta varios tipos de tráfico - comunicación GPU-a-GPU, RDMA entre servidores, lecturas y escrituras de almacenamiento, ingestión de conjuntos de datos, puntos de control, registro y orquestación - pero la parte más sensible al rendimiento-es el tejido de entrenamiento de backend que transporta el tráfico de GPU-a-GPU durante el entrenamiento distribuido. Cuando esa estructura es lenta o impredecible, las GPU esperan en lugar de calcular.
Es por eso que un tejido de IA se juzga de manera diferente a una red de centro de datos normal. El ancho de banda bruto es importante, pero también lo es la coherencia de la latencia, el comportamiento de congestión, la pérdida de paquetes, la profundidad de la telemetría, la topología e incluso el consumo de energía óptica.
Por qué las cargas de trabajo de IA ejercen una presión diferente sobre la red
El entrenamiento distribuido se sincroniza constantemente
Los modelos grandes se entrenan en muchas GPU que intercambian gradientes y activaciones en fases coordinadas - patrones colectivos como Todo-Reducir y Todo-a-Todo. La consecuencia es contundente: el camino más lento puede retrasar un paso completo del entrenamiento. Incluso si el 99% de los enlaces están en buen estado, un enlace de rack-a-spine congestionado puede convertir una GPU en un rezagado que todos los demás esperan.
La latencia de cola desperdicia GPU, no la latencia promedio
La latencia promedio es la métrica incorrecta aquí. Debido a que un paso de sincronización espera a que llegue la última GPU, unos cuantos paquetes retrasados pueden retrasar todo el trabajo. En un clúster de 256 GPU, un único enlace activo que agrega latencia de cola a un riel puede reducir la utilización en todo el trabajo.
El tráfico de IA está hecho de flujos de elefantes
Las redes tradicionales hacen malabarismos con muchos flujos pequeños; Los clústeres de IA generan algunos flujos de GPU-de GPU-a-GPU grandes y de larga duración. El hash ECMP predeterminado distribuye flujos, no bytes, por lo que cuando varios flujos elefante se aplican al mismo enlace de rack-a-spine, ese enlace se activa mientras que los enlaces paralelos permanecen inactivos -, lo que produce acumulación de colas, picos de latencia y, finalmente, caídas. Una mayor velocidad del puerto no soluciona este problema por sí sola: un enlace de 400G aún se congestiona si Elephant fluye mal hacia él.
La pérdida de paquetes es especialmente costosa
El TCP ordinario tolera pérdidas; La RDMA basada en RoCEv2-no. Se espera que la estructura se comporte con pérdidas-bajas o sin pérdidas, y las caídas durante la congestión pueden colapsar el rendimiento de RDMA. Esta es la única razón por la que un tejido RoCEv2 necesita una ingeniería deliberada sin pérdidas en lugar de un reenvío del mejor esfuerzo.
Requisitos básicos para una red de clústeres de IA
Una buena estructura backend tiene que satisfacer varios requisitos a la vez: alto ancho de banda de bisección para que muchas GPU puedan comunicarse simultáneamente sin que la estructura se convierta en un cuello de botella; bajoy predeciblelatencia, ya que los picos ocasionales de congestión son tan dañinos como una latencia promedio alta; transporte sin pérdidas o casi-sin pérdidas para RoCEv2; una topología que escala sin acumular saltos ni cables; y visibilidad operativa profunda. En ese último punto - sin telemetría, los equipos habitualmente diagnostican erróneamente un problema de congestión de la red como un problema de GPU o de cómputo y pasan días buscando la capa equivocada.
Arquitectura de red de clúster de IA: tejido frontend frente a backend
La decisión temprana más importante es si se debe separar la red frontend del tejido de capacitación backend. La interfaz ofrece acceso de usuarios, administración, orquestación, monitoreo, registro, acceso al almacenamiento, ingesta de conjuntos de datos y transferencias de puntos de control. - puede parecerse mucho a una red de centro de datos convencional, aunque el almacenamiento y los puntos de control aún exigen un rendimiento real. El backend está dedicado al tráfico de entrenamiento de GPU-a-GPU y está optimizado para RDMA, baja latencia, transporte sin pérdidas y ancho de banda predecible.
Esta separación no es teórica. El trabajo publicado de Meta sobreRedes RoCE para entrenamiento distribuido de IA a escaladescribe exactamente esta división: una red frontend para tareas como la ingesta de datos, puntos de control y registro, y un tejido RoCEv2 backend dedicado que conecta las NIC RDMA en una arquitectura sin bloqueo para la comunicación GPU. SuDocumento SIGCOMM 2024 sobre RDMA sobre Ethernet a metaescalaenmarca la misma idea como principio de diseño: primero comprenda la carga de trabajo y luego separe el entrenamiento de GPU en su propia red backend para que pueda evolucionar y escalar de forma independiente.
Por qué vale la pena: separar dominios mejora la previsibilidad del rendimiento, la claridad en la solución de problemas, el aislamiento y el ajuste del control de la congestión. Si el almacenamiento, la administración y la capacitación comparten un mismo tejido sin una QoS cuidadosa, una escritura intensa en el punto de control puede detener la comunicación de capacitación en el peor momento posible. En el diseño de Meta, los conmutadores de hoja conectan las GPU dentro de un bastidor a través de un DAC de cobre, mientras que los enlaces del bastidor-a-la columna se ejecutan en fibra monomodo-con transceptores de 400G - un patrón que se asigna claramente a estructuras estructuradas.Cableado troncal MPO/MTPentre los niveles de hojas y espinas.

RoCEv2 y Ethernet sin pérdidas: cómo funcionan juntos
RDMA (Acceso remoto directo a la memoria) permite que un sistema lea o escriba la memoria de otro sistema con una participación mínima de la CPU, que es lo que hace posible la transferencia de GPU-a-GPU de baja-latencia y alto-rendimiento. RoCEv2 transporta ese tráfico RDMA a través de Ethernet encapsulándolo en UDP/IP, para que pueda construir la estructura en una conmutación Ethernet estándar.
El atractivo es la amplitud del ecosistema. Ethernet tiene una enorme base de proveedores, operaciones maduras y una rápida evolución en silicio, óptica y herramientas de conmutación. ElConsorcio Ultra Ethernethace de este su argumento central: una pila Ethernet abierta, interoperable y de múltiples proveedores, ahora formalizada en su especificación 1.0, diseñada-específicamente para escalar las redes de IA y HPC sin depender de un proveedor-. NVIDIA ha impulsado la misma dirección desde el lado del producto - suPlataforma Ethernet Spectrum-Xse posiciona como Ethernet diseñado específicamente para IA, agregando transporte sin pérdidas, enrutamiento adaptable y telemetría en-red a Ethernet estándar.

El tejido sin pérdidas RoCEv2, componente por componente
"Lossless" no es un solo interruptor, es una pila de mecanismos cooperativos. La siguiente tabla muestra el nivel de detalle que realmente necesita un diseño.
| Componente | Role | Por qué es importante |
|---|---|---|
| Clasificación de tráfico (DSCP/PCP) | Coloca a RDMA en la clase sin pérdidas | Una marca incorrecta envía RDMA a una cola con pérdidas |
| PFC | Pausa en el nivel-de enlace para evitar caídas | Una red de seguridad; el mal uso provoca tormentas de pausas y bloqueos de cabecera-de-línea |
| ECN | Marca los paquetes antes de que las colas se desborden | Debe activarse antes de PFC para que sea útil. |
| DCQCN | Control de velocidad de NIC impulsado por retroalimentación ECN/CNP | Reduce la frecuencia con la que se debe disparar PFC |
| Equilibrio de carga dinámico/adaptativo | Esparce flujos de elefantes por los caminos | El hash ECMP predeterminado deja los enlaces activos e inactivos |
| Telemetria | Expone caídas, marcas ECN, pausas PFC y profundidad de la cola | La única manera de correlacionar la salud del tejido con la salud del trabajo |
Estos deben sintonizarse entre sí. La relación crítica es que el umbral ECN debe situarseabajoel umbral de PFC de entrada, por lo que los remitentes reducen la velocidad antes de que se necesiten fotogramas de pausa. enebroDocumentación DCQCNdescribe este acto de equilibrio con precisión: deje que ECN haga el control de flujo cortando la velocidad de transmisión temprano, de modo que se minimice el PFC - que detiene el flujo por completo -. Configure ECN demasiado alto y PFC se activa primero y con frecuencia; configure PFC de manera demasiado agresiva y obtendrá tormentas de pausas.
Lo que esto significa en la práctica: los contadores PFC no son una métrica de éxito. Si los cuadros de pausa de PFC aumentan de manera constante durante las carreras de entrenamiento normales, el tejido no está saludable - está sobreviviendo a la congestión al detener el tráfico. Un tejido verdaderamente saludable muestra que ECN hace el trabajo y PFC rara vez participa.
Desafíos comunes de las redes de clústeres de IA y cómo resolverlos
Desafío 1: latencia de cola y rezagados
Problema:En el entrenamiento sincronizado, un camino lento retrasa todo el trabajo.Hacer:mantener el backend bajo-salto; evitar suscripciones excesivas innecesarias; monitorear la latencia de la cola, no los promedios; utilizar equilibrio de carga consciente de la congestión-; valide con patrones de tráfico colectivos en lugar de pruebas punto-a-puntos.En la práctica:un trabajo cuya utilización de GPU afecta cada intervalo de sincronización suele alcanzar un camino rezagado, no un límite de cómputo.
Desafío 2: Congestión y colisiones de flujo-de elefantes
Problema:algunos flujos grandes aterrizan en el mismo enlace y crean un punto de acceso.Hacer:no confíe en el ECMP predeterminado para un tejido de IA grande; habilitar el equilibrio de carga dinámico/adaptativo; observar la utilización por-la columna vertebral del enlace y la profundidad de la cola; Deje que ECN y DCQCN aceleren los remitentes antes de que persista la congestión.En la práctica:La utilización desigual del enlace-columna con todo lo demás nominal es la señal de un hashing de flujo deficiente, no de un ancho de banda insuficiente.
Desafío 3: Escalar de 400G a 800G
Problema:A medida que aumenta el número de GPU, los enlaces-de menor velocidad obligan a utilizar más conmutadores, niveles, ópticas y cableado.Hacer:calcular el ancho de banda requerido por GPU y por rack (un servidor de 8-GPU con una NIC de 400G por GPU es una estructura muy diferente a un diseño de 200G); decidir si no-bloquear o tener un ligero exceso de suscripción a propósito; considere la base del switch, la velocidad del puerto y la profundidad de la topología en conjunto; planifique el camino de 400G a 800G antes de verse obligado a seguirlo; mantenga la óptica, el cableado y la alimentación en el diseño desde el primer día.
Desafío 4: selección de potencia, refrigeración y óptica
Problema:Los tejidos de IA consumen mucha energía, especialmente a altas velocidades de puerto y densidad óptica.Hacer:use DAC para abreviar enlaces en-rack cuando sea práctico; utilice AOC o transceptores ópticos para recorridos más largos entre bastidor-hasta-lomo; comparar potencia entre opciones ópticas; validar los límites térmicos en puertos-de alta densidad; Diseñe el cableado y el flujo de aire juntos. Elegir entretransceptores monomodo-y multimodoes en gran medida una decisión de alcance-versus-coste, y debe tomarse por clase de enlace, no una sola vez para todo el clúster.
La potencia óptica es ahora una restricción de diseño de primer-orden, no una nota a pie de página. El trabajo de NVIDIA enTejidos de IA energéticamente-eficientes con Spectrum-X Ethernet Photonicsilustra la tendencia directamente: la fotónica de silicio co-empaquetada se está utilizando para reducir la energía por-puerto y reducir las fluctuaciones de enlace en comparación con la óptica enchufable tradicional, precisamente porque los transceptores se encuentran entre los componentes de mayor-potencia y mayor-fallo-en un grupo grande.
Desafío 5: Visibilidad y resolución de problemas de puntos ciegos
Problema:Sin telemetría, un problema de red parece un problema informático.Hacer:supervise las caídas de paquetes, las marcas ECN, los fotogramas de pausa de PFC, la ocupación de colas, los errores de enlace, la utilización de puertos, la distribución de flujo, los contadores de congestión de NIC, la utilización de GPU y el tiempo de finalización de trabajos - y luego correlacione las métricas de tejido con las métricas de trabajos de IA. Un switch-que parezca silencioso no garantiza un trabajo de entrenamiento saludable y una GPU ocupada no garantiza un progreso útil.
RoCEv2 vs InfiniBand para redes de clústeres de IA
Tanto RoCEv2/Ethernet como InfiniBand ejecutan clústeres reales de IA y HPC; la elección depende de la escala, las habilidades del equipo, el ecosistema, el modelo de costos y los objetivos operativos. La siguiente tabla es una comparación editorial, no una clasificación absoluta. - la respuesta correcta es específica de la carga de trabajo- y de la organización-.
| Factor | RoCEv2/Ethernet | InfiniBand |
|---|---|---|
| Ecosistema | Operaciones amplias, de múltiples proveedores y familiares | Sólida herencia de HPC, pila madura de alto-rendimiento |
| Operaciones | Reutiliza habilidades de Ethernet, pero necesita un ajuste cuidadoso y sin pérdidas | Más especializado, diseñado-específicamente para HPC estrechamente acoplado |
| Flexibilidad de abastecimiento | Generalmente hay más opciones de proveedores | A menudo una pila más integrada |
| Actuación | Fuerte cuando se diseña y ajusta adecuadamente | Conocido por su baja latencia en clústeres estrechamente acoplados |
| Escalada | Necesita topología deliberada, control de congestión y telemetría. | Opciones sólidas para tejidos grandes de estilo HPC- |
| Mejor ajuste | Equipos que buscan flexibilidad de Ethernet y un diseño RoCEv2 preparado para IA- | Equipos que priorizan HPC integrado y estrechamente acoplado |
La verdadera pregunta no es qué tecnología gana en abstracto. Se trata de si la estructura elegida puede ofrecer ancho de banda predecible, baja latencia, baja pérdida y visibilidad operativa en la escala de GPU de destino.
Escala de GPU frente a diseño de red
Un clúster de laboratorio de 64-GPU y un clúster de producción de varios-miles de GPU no son el mismo proyecto con un número de puertos diferente. La escala cambia el diseño.
| Escala de conglomerado | Diseño típico | Enfoque primario |
|---|---|---|
| Hasta ~64 GPU (laboratorio/piloto) | Un solo-nivel o una pequeña-hoja-de dos niveles, a menudo un dominio de cambio | Configuración correcta de RoCEv2, cableado limpio, telemetría básica |
| ~128–512 GPU | Lomo-de dos-hojas-de niveles sin bloqueo, separación frontend/backend | Objetivo de sobresuscripción, equilibrio de carga dinámico, ajuste ECN/PFC |
| ~1000–4,000+ GPU (producción) | Backend de escala-multi{0}}nivel o ferrocarril-optimizado-centro de datos- | Programación basada en topología-, 400G/800G, potencia y densidad óptica |
Paso-a-paso Marco de diseño de redes de clústeres de IA
Paso 1: definir la carga de trabajo y la escala de GPU
Comience con la carga de trabajo, no con el modelo de cambio. Aclare el recuento de GPU ahora y el próximo ciclo, ya sea que el trabajo sea entrenamiento,-ajuste fino, inferencia o mixto, los patrones colectivos esperados, el tamaño del punto de control, el volumen de tráfico de almacenamiento y si el clúster es de un solo- o de múltiples-inquilino.
Paso 2: dominios de tráfico separados
Decida qué pertenece al frontend frente al backend: administración, almacenamiento y punto de control, capacitación/RDMA y monitoreo del tráfico. Para implementaciones pequeñas, puede ser suficiente la separación lógica con VLAN y QoS; para clústeres más grandes, la separación física entre el frontend y el backend suele ser más fácil de operar y de razonar.
Paso 3: elija la topología y el objetivo de sobresuscripción
Leaf-spine es el valor predeterminado para estructuras AI Ethernet escalables. Decida uno, dos o más niveles; sin-bloqueo versus sobresuscripción; GPU por bastidor; NIC por servidor; velocidad y recuento del enlace ascendente; capacidad de la columna; y tamaño del dominio de falla. Para el tráfico de capacitación de backend, una menor sobresuscripción genera previsibilidad - y, si se suscribe en exceso, conviértalo en una proporción deliberada basada en el comportamiento medido de la carga de trabajo, no en un accidente de recuento de puertos.
Paso 4: seleccione la velocidad del conmutador y la densidad del puerto
Elija plataformas de conmutación según el ancho de banda, la topología y el crecimiento requeridos - evaluando 400G frente a 800G, base, capacidad total, arquitectura de búfer, compatibilidad con RoCEv2/PFC/ECN/DCQCN, telemetría, potencia por puerto y NOS/automatización. No evalúe la velocidad únicamente: un cambio rápido sin el control de congestión, el almacenamiento en búfer y la telemetría adecuados seguirá creando problemas en el tráfico de IA.
Paso 5: Planificar las NIC, la óptica, el DAC/AOC y el cableado
La tela es más que interruptores. Planifique la velocidad de la NIC por GPU, la NIC-para-cambiar el tipo de enlace, el DAC para enlaces cortos de cobre, el AOC y los módulos ópticos para tiradas más largas, la óptica monomodo-para distancia y la planta de fibra, el diseño de parches, el etiquetado y el acceso al servicio. Aquí es importante conseguir el factor de forma conectable correcto - aDescripción general de los factores de formulario-QSFP-DD y OSFPVale la pena echarle un vistazo antes de comprometer los puertos de switch y NIC a 400G/800G. En lo que respecta al cableado, dividir un puerto de switch de alta-densidad en enlaces por-servidor generalmente significaCableado multiconector MPO-a-LC, y el grado de fibra debe coincidir con la distancia - la prácticaLímites de alcance de fibra multimodo (OM1–OM5)Decide dónde sigue funcionando el modo multimodo y dónde se requiere el modo único-. Un diseño de cableado deficiente puede hacer que una topología técnicamente correcta sea imposible de operar.
| clase de enlace | Distancia típica | elección común |
|---|---|---|
| En-GPU en rack-a-hoja | Menos de ~3 m | DAC (cobre) |
| Bastidor-adyacente | ~3–7 m | AOC o DAC |
| De hoja-a-lomo dentro de una sala | Decenas de metros a ~100 m | Multimodo (OM4/OM5) + óptica SR o monomodo- |
| Entre pasillos/escala DC- | ~100 ma 2 km | Transceptores-monomodo + 400G/800G |
Paso 6: Configurar el control de congestión y transporte sin pérdidas
Esta es la parte más sensible del despliegue. Clasifique el tráfico RoCEv2 correctamente y asígnelo a la prioridad correcta; habilitar PFC en esa prioridad; establecer umbrales de ECN por debajo del umbral de PFC; confirmar que las NIC implementan la respuesta DCQCN prevista; mantener el tráfico no relacionado fuera de la clase sin pérdidas; y pruebe explícitamente tormentas de pausa y bloqueo de cabecera-de-línea. Trate el PFC como un mecanismo de seguridad, no como la forma cotidiana de gestionar una red congestionada.
Paso 7: Validar con telemetría e inteligencia artificial-como tráfico de prueba
Antes de ejecutar los trabajos de producción, valide el ancho de banda de extremo a extremo, la distribución de latencia, la latencia de cola, las caídas de paquetes, el comportamiento de marcado ECN, la frecuencia de pausa de PFC, la recuperación de fallas de enlace-, la distribución de flujo y el rendimiento del trabajo de GPU bajo carga. El rendimiento de iperf simple no es suficiente - verificar el marcado ECN, la pausa de PFC, la profundidad de la cola y NCCL-reducen el rendimientojuntos, porque una estructura que pasa pruebas punto-a-puntos todavía puede atascarse en la comunicación colectiva sincronizada.
Preguntas frecuentes: redes de clústeres de IA
P: ¿RoCEv2 realmente puede reemplazar a InfiniBand para el entrenamiento de IA?
R: Para muchos clústeres, sí - cuando la estructura Ethernet está diseñada y ajustada correctamente. Los grandes operadores realizan capacitación de producción en backends RoCEv2, y tanto el Ultra Ethernet Consortium como las plataformas de proveedores como NVIDIA Spectrum-X están impulsando Ethernet específicamente hacia el rendimiento a escala de IA-. La advertencia es que RoCEv2 exige una ingeniería deliberada sin pérdidas; no "simplemente funciona" desde el primer momento como lo haría un tejido HPC diseñado específicamente-.
P: ¿Cuándo necesito realmente 800G en lugar de 400G?
R: Cuando la demanda de ancho de banda por-GPU y por-rack supera lo que los enlaces de 400G pueden transportar sin agregar niveles, cables ni ópticas. Los desencadenantes habituales son servidores densos con una NIC por GPU de alta-velocidad y clústeres más grandes donde, de otro modo, se produciría una sobresuscripción. Planifique el camino de la migración con anticipación para que 800G sea un paso, no un rediseño.
P: ¿Qué sucede si PFC está mal configurado?
R: Una mala configuración de PFC puede causar tormentas de pausas, bloqueo-de-línea principal y propagación de la congestión, donde pausar un enlace retrasa el tráfico en toda la estructura. Es por eso que ECN debería transmitir la mayor parte de la señalización de congestión y PFC rara vez debería participar; El aumento de los contadores de PFC durante las ejecuciones normales es una señal de advertencia, no un indicador de éxito.
P: ¿Es necesario aislar físicamente una red de clúster de IA?
R: No siempre, pero los clústeres más grandes generalmente se benefician al separar físicamente el tejido de entrenamiento backend del frontend. Las implementaciones más pequeñas a menudo pueden utilizar separación lógica con VLAN y QoS, siempre que el almacenamiento y las ráfagas de puntos de control se mantengan fuera de la clase de capacitación sin pérdidas.
P: ¿Cómo elijo entre transceptores DAC, AOC y ópticos?
R: Por distancia y potencia. DAC se adapta a enlaces de cobre cortos en-rack; AOC cubre recorridos ligeramente más largos y flexibles; y transceptores ópticos con fibra-multimodo o monomodo que manejan distancias de bastidor-a-lomo y transversal-pasillo. Haga coincidir el grado de fibra con el alcance y sopese la potencia óptica, ya que los transceptores representan una parte importante tanto de la potencia de la tela como de la tasa de fallas.
P: ¿Los clústeres de GPU pequeños necesitan una estructura completa sin pérdidas?
R: Todavía necesitan una configuración correcta de RoCEv2 - clasificación, PFC en la prioridad correcta y ECN por debajo de PFC -, pero un pequeño clúster de dominio único-a menudo puede omitir la topología de múltiples-niveles y la intensa planificación de sobresuscripción que requieren los grandes fabrics. El comportamiento sin pérdidas no es opcional; la complejidad-de escalamiento horizontal es.
Conclusión y siguiente paso
La red de clústeres de IA decide si las GPU funcionan como un sistema coordinado o como si estuvieran inactivas esperando datos. Un diseño sólido combina un gran ancho de banda, latencia predecible, transporte RoCEv2 sin pérdidas, una topología de hoja-espina escalable, la óptica y el cableado correctos y una telemetría lo suficientemente profunda como para correlacionar el estado de la estructura con el estado del trabajo. Los clústeres pequeños lideran con una topología limpia y una configuración RoCEv2 correcta; Los clústeres grandes también deben abordar la separación frontend/backend, el equilibrio de carga consciente de la congestión-, la migración de 400G/800G, la densidad de energía y las operaciones impulsadas por la telemetría-.
El mejor paso siguiente es corregir primero sus entradas: escala de GPU, patrón de carga de trabajo, diseño de rack y dominios de tráfico. Luego seleccione los conmutadores, las NIC, la óptica y la configuración de Ethernet sin pérdidas que coincidan. Si está examinando el lado del cableado óptico y{2}}estructurado de una estructura de GPU en paralelo, nuestroSoluciones de cableado y fibra para centros de datos.puede ayudarle a hacer coincidir las opciones de troncales, conexiones y transceptores con su topología y distancias de enlace. En la infraestructura de IA, la red adecuada no sólo es más rápida - sino que también es más predecible, más observable y más fácil de escalar.